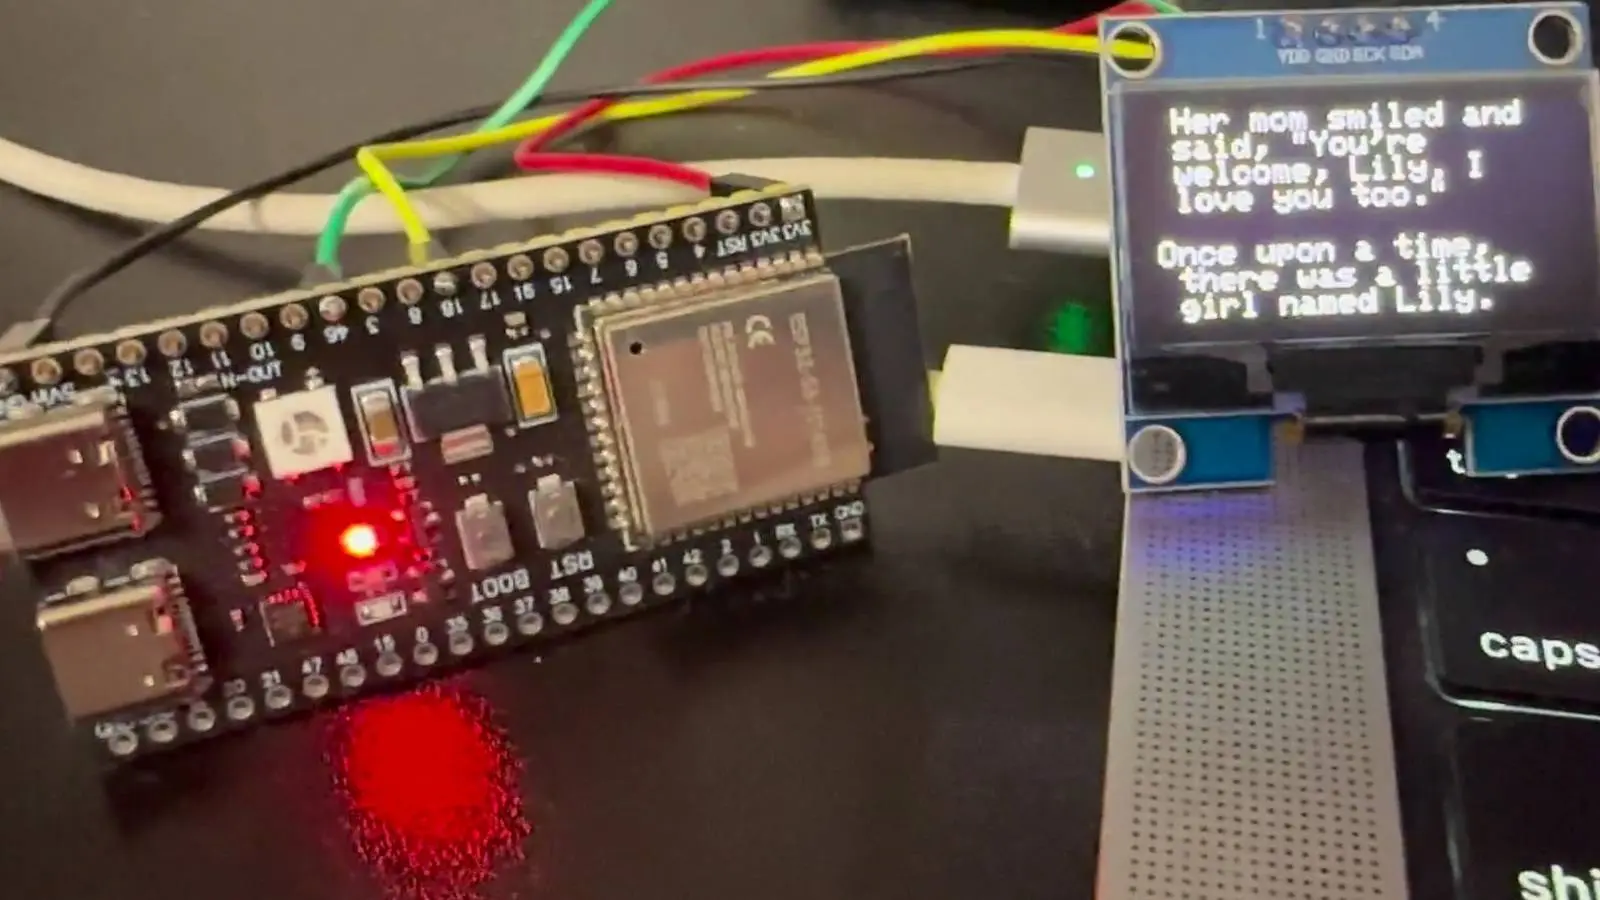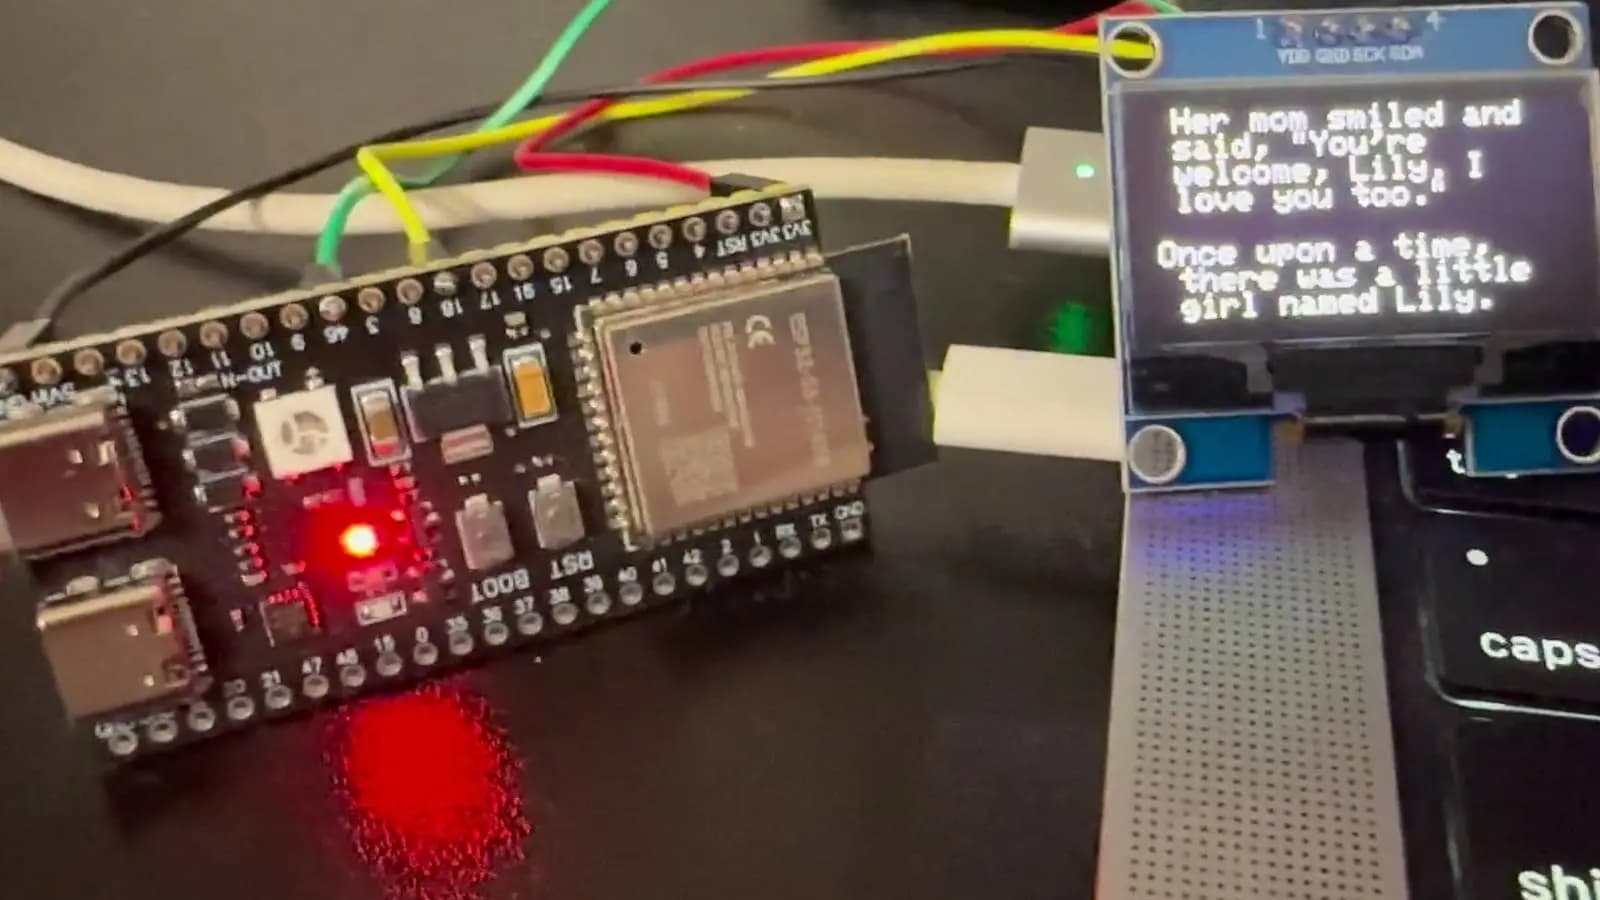
Un usuario del subreddit ESP32 logró ejecutar un modelo de lenguaje grande (LLM) con 28.9 millones de parámetros en un microcontrolador ESP32-S3, permitiendo generar historias coherentes pese a las limitaciones de memoria y procesamiento del dispositivo.
Por qué importa: Este avance muestra que es posible implementar IA avanzada en hardware extremadamente limitado, abriendo puertas a aplicaciones de inteligencia artificial local en dispositivos embebidos.
Lo esencial
- El modelo de lenguaje tiene 28.9 millones de parámetros, cerca de una cuarta parte del ChatGPT original.
- Se usa memoria flash mapeada para almacenar la tabla de embeddings de 25 millones de parámetros.
- El núcleo denso que requiere memoria rápida ocupa solo unos 560 KB de RAM, logrando ~9 tokens por segundo.
Innovación técnica en ESP32-AI
El proyecto, denominado ESP32-AI, aprovecha una técnica llamada "Gemma's Per-Layer Embeddings" para almacenar la mayor parte del modelo en la memoria flash mapeada (XIP). Esto permite mantener la tabla de embeddings de 25 millones de parámetros en flash, que se accede leyendo solo unas pocas filas por token generado. De esta forma, el microcontrolador solo necesita mantener en RAM un núcleo denso pequeño, optimizando el uso de recursos limitados.
Rendimiento y capacidades del modelo
Aunque el modelo tiene menos parámetros que los grandes LLMs comerciales, puede generar textos coherentes y mantener el seguimiento de variables en las historias que crea. Su velocidad de procesamiento es de aproximadamente 9 tokens por segundo, un rendimiento notable para un chip con restricciones de memoria y potencia como el ESP32-S3.